買ったらすぐローカルエージェント型AIが始められるRTX Spark N1Xのすべて
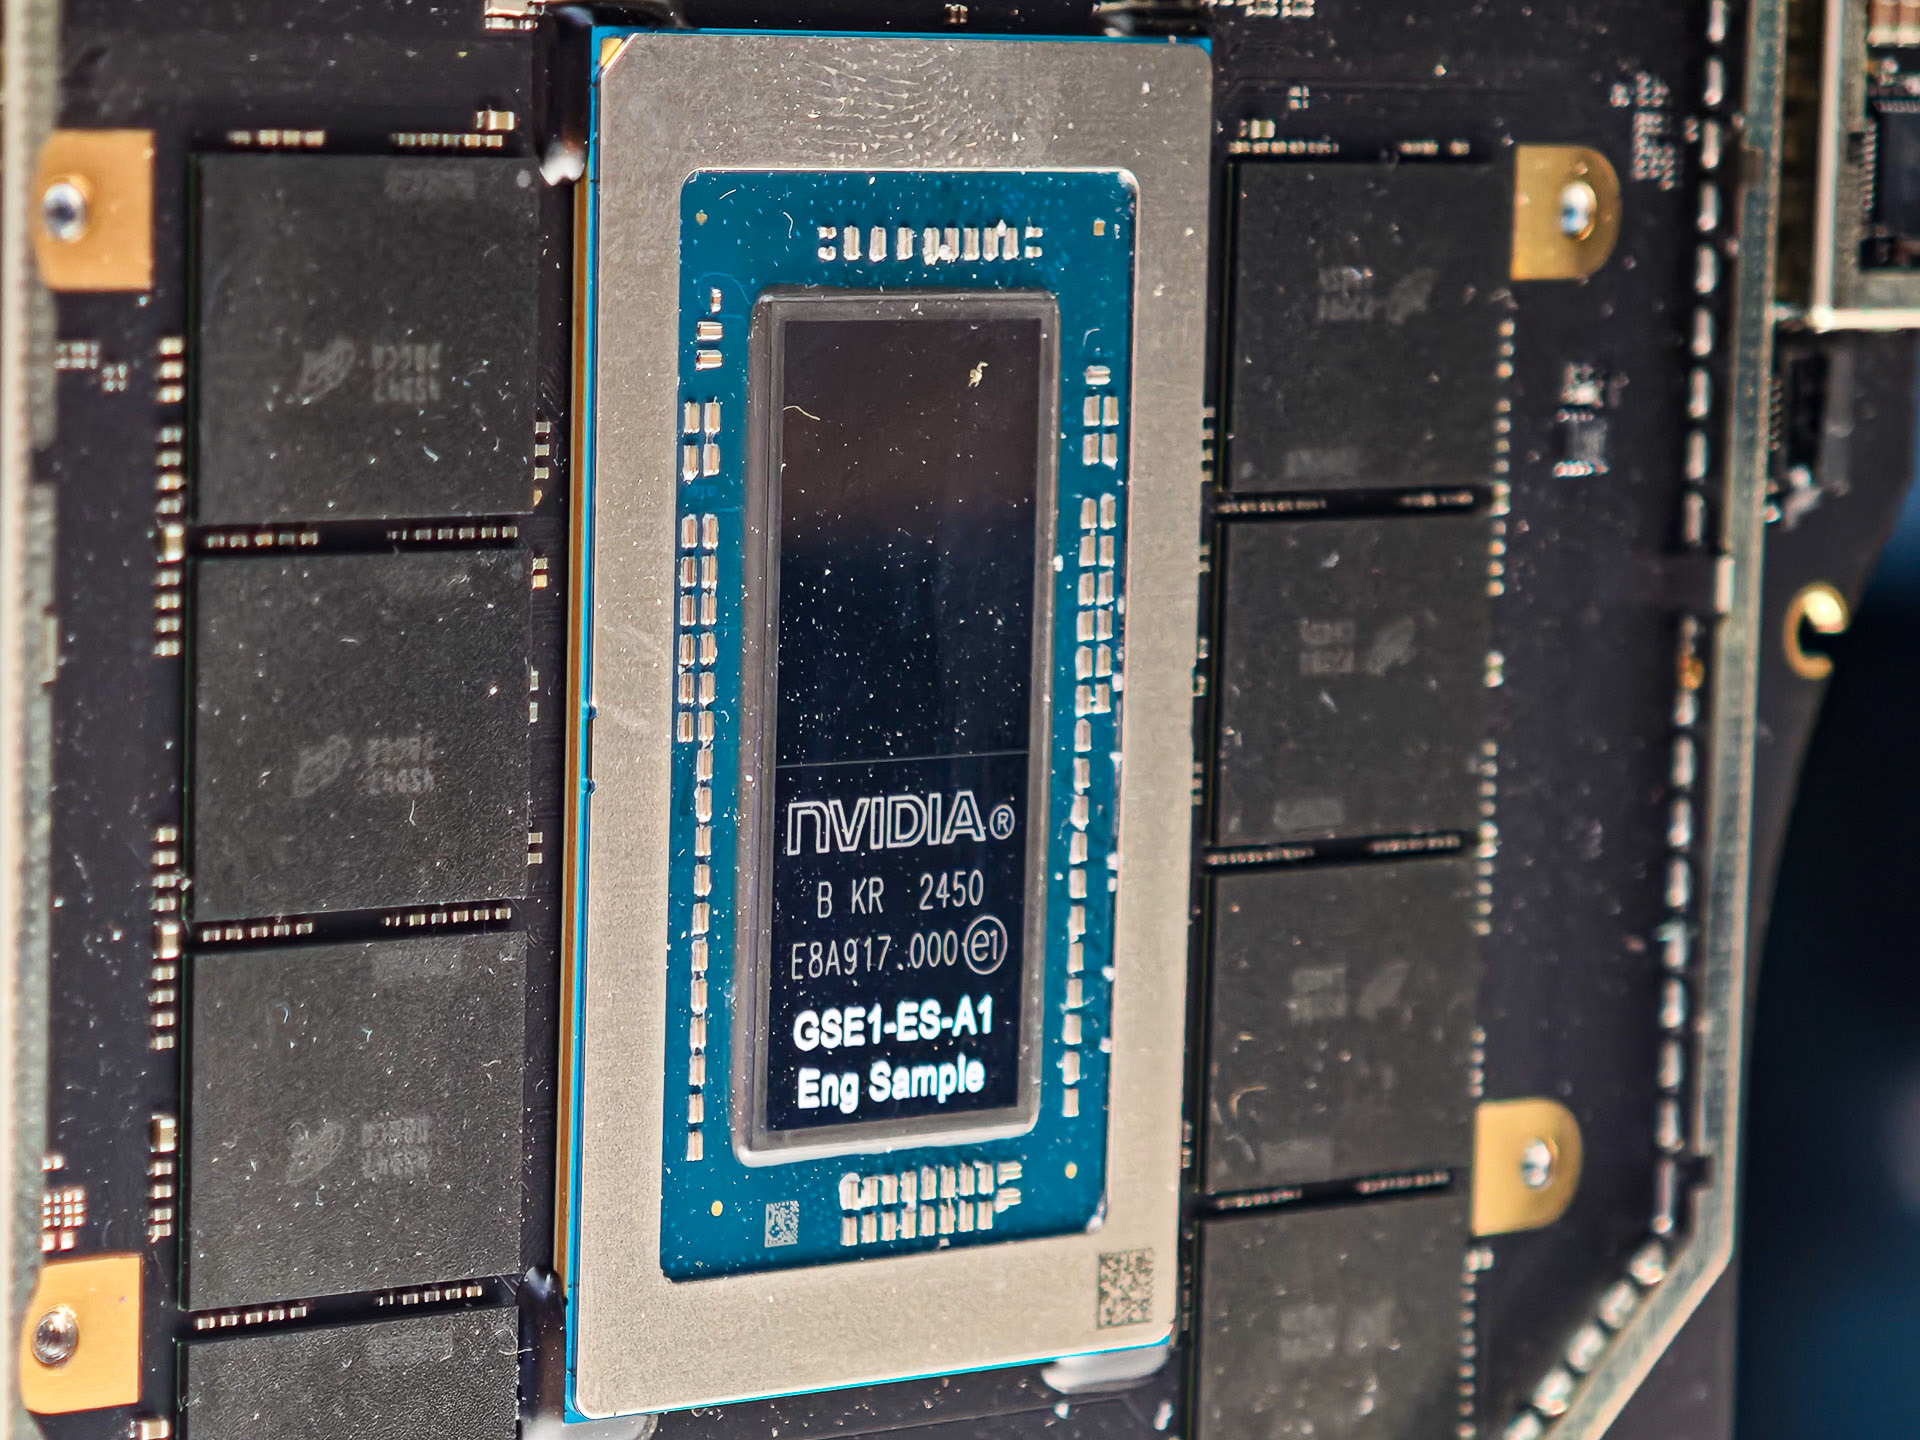
NVIDIAは10月15日(現地時間)、「RTX Spark N1X」の詳細を明らかにした。TSMC 3nmで製造されるCPUダイとGPUダイの2チップで構成されるチップレット構造。CPUダイはMediaTekがカスタム設計したもので、10コアのCortex-X925と10コアのCortex-A725から構成された20コアCPUを搭載する。32MB(16MB×2)のL3キャッシュと256bit/16チャンネルのメモリコントローラを備えており、LPDDR5X-9400を利用すると300GB/sの帯域幅を実現する。GPUダイは48SM/6,144CUDAコアの構成で、24MBのL2キャッシュと、CPUに接続するためのNVLink C2Cを備えている。
CPUとGPUの2つのチップを合わせたcTDP(Configurable TDP)は、45~80WでOEMメーカーが自社の熱設計に合わせて設定できる仕様になっている。最も重要なことは、RTX Sparkを搭載したWindows PCでは、指示に従ってOpenClawなどのエージェント型AIを導入していくことで、簡単にローカルのフロンティアAIモデルを利用して、自動化処理などを実行できるようになることだ。ローカルエージェント型AIの「大衆化」が実現されているのだ。
最近のNVIDIAは、製品の開発コード名を製品ブランドとしてそのまま利用することが多い。端的な例は、データセンター向けの製品で、CPUのVera、GPUのRubinという開発コードネームがそのまま製品名として利用されている。今回発表されたRTX Sparkもその列に加わった形で、プラットフォームの名称であるRTX Sparkに開発コードネームである「N1X」をつけた「RTX Spark N1X」が正式な製品名となった。
製品のSKUは2つで、RTX Spark N1X(6144-core GPU, 20-core CPU)およびRTX Spark N1X(5120-core GPU, 18-core CPU)となる。製品名からも分かるように、フル仕様からCPUとGPUの演算器をわずかに削ったものが下位SKUということになる。
なお、上位SKUはメモリの上限が128GBになるが、下位のSKUでは上限が32GBになるのも大きな違いになる。特に、今回のRTX Sparkの主要な用途であるフロンティアAIモデルのローカル実行、ハーネスのローカル実行ではメモリ容量が重要になる。このためフロンティアAIモデルやハーネスのローカル実行を重視するのであれば、48GB、64GB、128GBのメモリ構成を選べる上位SKUを選ぶべきだ。
RTX Spark N1Xは、いわゆるチップレットの構造になっており、MediaTekが設計したCPUダイ、NVIDIAが設計したGPUダイの2つのダイが2D方向に混載されている。いずれのダイもTSMCの3nmで製造されている。
2つのチップ合わせてのcTDP(Configurable TDP)は45~80Wで、可変仕様となっている。80Wに設定すればピーク時の性能は向上するものの、CPUとGPU合わせて80Wの消費電力になったときに発生する熱量を確実に放熱できる熱設計にする必要がある(当然だがTDPをあげると、それに伴って消費電力そのものも増える)。具体的には、ヒートシンクやファンなどにやや大きめなものを採用する必要があり、当然ながら重量にはよくない影響がある(ヒートシンクやファンは基本的に大きさに比例して重量が増えるため)。
逆にいえば、同じRTX Spark N1X(6144-core GPU, 20-core CPU)であっても、OEMメーカーが設計ポイントとしてcTDP 80Wを選んだのか、あるいは途中の46~79Wのどこかを選んだのか、最低の45Wを選んだのかによって性能が変わってくるということだ。
その意味では、PCメーカーのスペック表にcTDPのどこを選んで設計したのか書いておいてほしいところだが、残念ながらそうではないのが現状だ。RTX Sparkの中でもさらに性能がよいものを買いたいというユーザーは製品レビューなどでのベンチマークの結果などを参考にしながら選ぶのがいいだろう。
CPUダイは、SoCの機能としてはGPU以外の部分、CPUコア、メモリコントローラ、NPU、I/O、ディスプレイコントローラなどの機能が統合されている。CPUコアは、Armが開発したIPデザインとなるCortex-X925が10コア、Cortex-A725が10コアとなっている。Armとしては、X925がシングルスレッドの性能を重視したプライムコア、A725がマルチスレッド時の性能とアイドル時に低消費電力を実現する高性能コアとなるが、NVIDIAはX925をパフォーマンスコア、A725を高効率コアと呼んでいる。
Cortex-X925は、以前のArm Cortexシリーズの弱点だったシングルスレッドの性能を引き上げる設計がされている。キャッシュ階層の強化によるメモリレイテンシの削減などが施されており、従来のCortexシリーズよりもシングルスレッド性能が高くなっている。このCortex-X925が10コア、そして省電力なCortex-A725が10コアと合計で20コアのCPUが搭載されていることで、それらすべてを利用して演算するマルチスレッド時には高い性能を発揮する、それがN1XのCPUデザインとなる。
RTX Spark N1XのCPUはプライムコア、高性能コアどちらも5コア(下位SKUは9コア)で1つのCPUクラスタを構成しており、それぞれのクラスタに16MBのL3キャッシュ、つまりCPU全体で32MBのL3キャッシュが搭載されている計算になる。なお、Cortex-X925のL1キャッシュは64KB(命令)/64KB(データ)、L2キャッシュは2MBとなっている。このように非常にキャッシュ階層が充実したデザインになっている。
また、NVIDIAによれば、このCPUダイにはNVIDIAが設計したNPUが搭載されているという。しかし、このNPUに関してNVIDIAは存在を説明したものの、どのようなものであるかは具体的に説明しておらず、今後その性能や概要などが明らかになるかもしれない。特にNVIDIAが詳細に言及していないという事実に鑑みるに、大した性能ではない可能性が高いが……。ただ、NVIDIAが公開したCPUダイの写真には「NVIDIA NPU」という文字が入っているし、実際Surface Laptop Ultraの実機で確認するとNPUがあることが分かる。
I/O周りに関しては、USB4(最大4ポート)のサポート、PCIeのサポート(レーン数は明らかにされていない)、ディスプレイコントローラ、そしてNVLink C2Cなどがサポートされており、GPUダイがSoC内部のインターコネクトに近い帯域幅、低遅延で接続される形になっている。
メモリ周りとしては、LPDDR5X-9400の16bit幅のメモリコントローラが16チャンネル用意されており、最大で128GBまでのメモリ容量に対応する。合計では256bit幅でメインメモリにアクセスできる計算になり、最大300GB/sの帯域幅を実現している。
なお、RTX Sparkでは24GB、32GB、48GB、64GB……と比較的細かい単位でメモリ容量を選べ、実際にそうした製品が登場している。これはメモリコントローラが16bit単位になっているためだ。
GPUダイは、GPUのアーキテクチャ世代としてはBlackwellになる。dGPUのBlackwell世代は、GeForce RTX 50シリーズのアーキテクチャとなるが、GeForce RTX 50シリーズはいずれもTSMCの4nmで製造されているのに対し、RTX SparkのGPUダイは3nmとプロセスノードが微細化されていることが大きな特徴になる。
GPU内部の構成は、GeForce RTX 5070などに利用されているGB205のダイと同じ、48SM/6,144 CUDAコアとなる(アーキテクチャ上の上限、下位SKUでは40SM/5,120 CUDAコアになる)。
もう1つの違いは、GDDRのメモリコントローラの有無だ。dGPUでは、CPUとの接続に利用されているPCI Expressの帯域幅や低遅延などが十分ではなく、CPUに接続しているLPDDRやDDRなどのDRAMをローカルメモリとして利用することが難しい。
そこで、GPUのローカルメモリとしてGDDRと呼ばれるGPU専用のメモリがボード上に実装されている。GDDRは少ないデータ信号線でもメモリ帯域幅を高められるように、ピンあたりの帯域が最大化できるように設計された特定用途DRAM。ただ、特定用途向けに作られたメモリになるため、汎用のLPDDRやDDRに比べると高価という弱点があり、メモリ容量を大容量にすると高く付いてしまう。
それに対して、GPUを統合したPC向けのSoCで一般的に利用されているのは、CPUとGPUがメモリを共有するシェアードメモリだ。それが可能なのは、通常のSoCではCPUとGPUは同じダイもしくは同じパッケージに実装されているか、別チップでも内部バスに近い転送速度のインターコネクトを利用して接続されているためだ。
今回のRTX Spark N1Xでも、CPUダイ側にあるメモリコントローラが利用される。GPUは、PCIeに比べて高速なNVLink C2Cと呼ばれるチップ間NVLinkを通じてCPU側のメモリコントローラにアクセスし、メインメモリの一部をGPUのフレームバッファとして利用できる。NVLink C2Cは600GB/sの帯域幅を実現し、300GB/sの帯域幅となるメモリコントローラへのアクセスにも十分な帯域幅を実現している。
たとえば、一般的な接続バスとなるPCIeで、x16構成の場合には双方向で128GB/sの帯域幅を実現している。仮にGPUだけでメモリ帯域を使おうとすると、172GB/sも足りない計算になる。しかし、CPUやGPUの内部バスに近い動作をする600GB/sのNVLink C2Cを利用することで、そうした制限を避けられる。
CPUダイにあるメモリコントローラに接続されているのはLPDDR5X-9400のDRAMになる。このLPDDR5X-9400はGDDRのような特定用途向けではなく、ノートPCやスマートフォン向けとしては汎用になり、GDDRよりは安価に提供されている。このため、大容量化が容易で、たとえばGeForce RTX 50シリーズでは最大32GBまでのメモリしか提供されていないが、RTX Sparkでは最大128GBまで搭載できる。このことは、ローカルで大型のAIモデルを走らせるときに明確にメリットとなり、それがRTX Sparkを選ぶ理由の1つになる。
CPUとGPUそれぞれに割り当てるメモリ容量は、NVIDIA Appから設定できる。128GBメモリを搭載している場合には、GPU側に62.5GBが標準で割り当てられていた。GPUメモリへの割り当ては最大で96GB、最小で4GBの範囲内で設定することが可能で、ローカルAI重視ならGPUにできるだけ多くのメモリを割り当て、その逆に通常のアプリケーション重視であればCPU側に多くのメモリを割り当てることが可能になる。
ただ、たとえば96GBに設定すると、CPUが利用できるメモリが少なくなるので、スワップが多く発生してWindows自体の動作が遅くなったりする。その意味では標準の62.5GBあたりの方がバランスに優れている。
なお、この割り当ては動的に行なわれるわけではなく静的に行なわれるため、割り当てたあとはWindowsを再起動する必要がある。
Windows向けのSoCとしては、シェアードメモリは別に珍しい技術ではない。というのも、すでに2000年代からいわゆるiGPU(統合型GPU)というのはIntelのチップセットなどで普通に使われており、当時はチップセットのノースブリッジにあったメモリコントローラと1チップに統合され、ノースブリッジに接続されているメインメモリを共有していたからだ。その後、IntelのNehalem世代の後半から、CPU側にGPUもメモリコントローラも統合され、SoCとなっていった。その意味で、N1Xが特に珍しいというわけではない。AMD、Intel、Qualcommが提供しているWindows向けSoCと本質的に何かが変わるということはない。
では、従来のSoCとは何が違うのかというと、NVIDIAの強みであるNVIDIA GPUが統合されている点だ。これまでNVIDIAのGPUをWindowsノートPCに採用しようとすれば、dGPUを搭載しなければならなかった。チップが別になることで、そちらにも電力を供給しなければいけないため、電源周りの設計が複雑になってしまうし、ロスも増える。
また、チップが2つになると、熱設計の観点でも不利になる。たとえば、CPU側でTDP 35W、GPU側でTGP 80Wなどの設計の場合、100W以上の電力を消費しているときを想定して熱設計を行なう必要がある。それに対して今回のRTX Sparkでは両方合わせて最大TDP 80Wのデザインポイントで設計できるため、熱設計周りを簡素化できる。
では、そこまでしてNVIDIA GPUを使うメリットとは何か。それはシンプルに、NVIDIAが同社のGPU向けに開発したAIソフトウェアの資産を活用できることだ。
それはCUDA向けに作られたソフトウェア資産を利用できるということだけを意味しない。もちろんCUDA向けに開発されたソフトウェア資産を利用できることはメリットの1つだが、NVIDIAが開発している、オープンソースのAI関連のソフトウェアをいち早く利用できることが大きなメリットだ。
たとえば、OpenShellはその代表例といえる。OpenShellは、エージェント型AIのセキュリティ・制御機能で、コンテナ型のランタイムとして提供される。OpenShellは、コンテナ型のランタイムの中で、ユーザーがあらかじめ設定しておいた動作設定(このフォルダ/ファイルにはアクセスしてよいなどの許諾やネットワークへのアクセスなど)に基づいて、エージェント型AIの動作を規定する。OpenShellは隔離されたコンテナになっており、エージェント型AIからはアクセスして設定を変更できないため、エージェント型AIがユーザーの想定していない動作をすることを防ぐことができる。
Microsoftは、このOpenShellの機能をWindows OSレベルで実装したMXC(Microsoft eXecution Containers)について、10月7日(現地時間)にサンフランシスコで開催した発表会の中で一般提供の開始をアナウンスしている。これにより、これまで各エージェント型AIのハーネス(OpenClawなど)の中で設定する必要があったセキュリティ設定をMXCの設定で済ませられ、従来よりも容易に、高いセキュリティ性を確保したままエージェント型AIを活用することが可能になる。
極めつきはRTX Spark N1X搭載PCにプレインストールされているWindows 11(26H1)のOOBE(Out Of Box Experience)が終わってデスクトップが表示されたときの動作だろう。「Get Started(日本語: はじめに)」と表示されるウィンドウで、「開始する」を選んで次に進むと、表示されるのは「Hermes Agent」、「OpenClaw」、「Perplexity」という3つのエージェント型AIの選択肢だ。それを、指示に従ってインストールしていくと、すぐにエージェント型AIの導入が始まる。
つまり、「買って箱を開けたらすぐにエージェント型AI」という環境が実現されている。これこそがRTX Sparkの一番重要なポイントだと思う。
エージェント型AIが難しいことを考えなくても買ってすぐ使えるというのが、RTX Sparkの最大の特徴であることはすでに説明した通りだが、同時にRTX SparkはWindows OSに最適化されており、たった1つのことを除き、これまでのWindowsノートPCと何も変わらない感覚で利用できる。
そのたった1つのことは、CPUの命令セットアーキテクチャ(ISA)が一般的なノートPCで利用されているx86ではなく、Armであることだ。本誌の読者には釈迦に説法かもしれないが、ISAに関して説明しておくと、ソフトウェアがCPUに対して「こういう処理を行なってほしい」と「命令」するときに話す言葉だ。日本語しか話せない人と英語しか話せない人がコミュニケーションを取れないのと同じで、ISAが違うとソフトウェアが発行した命令をCPUが理解できないため、処理を行なえない。それを避けるためには、ソフトウェアもCPUも同じ言葉をしゃべる必要がある。
Arm ISAのCPUでは、x86 ISA向けに書かれているWindowsをそのままでは実行できない。このため、MicrosoftはArm版Windows(Windows on Arm: WoA)と呼ばれる、Arm ISA向けバージョンのWindowsを提供している。当初このWoAは、QualcommのSnapdragon用としてリリースされたが、今回のRTX Sparkリリースに合わせて、RTX Sparkにも対応した。
Windows OSの最大の特徴はプログラマブルなことで、アプリケーションソフトウェアをインストールして、ユーザー一人ひとりにカスタマイズして利用できる。このため、WoAではアプリケーションソフトウェアもArmに対応している必要がある。しかし、WoAの構想が最初に発表された2016年の末の段階では、OSすらなかったため、Arm ISAに対応したアプリケーションはまったくなかった。そこで、Microsoftが導入したのが、後にPrism(プリズム)と呼ばれるようになるバイナリトランスレーターだ。
Prismは、一般的なWindowsアプリケーションで利用されているx86(32bit)/x64(64bit)のISAをArm ISAのバイナリに変換しながら実行していく。同時に初回の起動時には、変換したデータ(x86/x64命令をArmに変換した後のバイナリ)をストレージ上に保存して、次回同じアプリケーションを起動したときにはそれをキャッシュとして利用することで高速に起動することが可能になる。
当初はそれこそMicrosoft純正アプリであるOfficeアプリ(現在のMicrosoft 365 Apps)すらx86/x64版しかない状態からスタートしたが、PrismのおかげでOfficeアプリが利用できていた。
こうした新しいプラットフォームでは、「鶏と卵問題」といってハードウェアがほとんどないから、ソフトウェアベンダーがソフトウェアを作らない、その逆にソフトウェアがないからハードウェアが売れないという悪循環が発生する。しかし、Prismで比較的スムーズにその問題を回避できて、その後QualcommのSnapdragon Xシリーズが本格的に立ち上がった2024年に本格的な普及期を迎えたというのが歴史的な背景になる。
ただし、Prismは万能というわけではない。Prismがバイナリ変換できるのは、Windows OSの2つの動作モード(ユーザーモードとカーネルモード)のうちユーザーモードと呼ばれる動作モードだけだ。
ユーザーモードは、一般的なアプリケーションソフトウェアが動作する動作モードで、OSが動作しているカーネルモードとは別のメモリ空間で動作している。メモリ空間が分けられているのは、アプリケーションがクラッシュしたときにOSを巻き込むことを防ぐため。
一方、このカーネルモードでは、グラフィックスドライバやプリンタドライバなどのデバイスドライバなどが動作しており、これらのデバイスドライバはPrismでは変換できないため、必ずArm版が必要になる。
今回NVIDIAは、RTX Spark N1XのGPUとなる「Blackwell RTX」用のArm版GPUドライバを製作してボックス版ドライバ(Windowsに初期導入されているドライバ)として提供している。また、同時に配布版も用意しており、今後はNVIDIAのWebサイトなどからダウンロードできるようになる。クリエイター用のノートPC向けのドライバパッケージ(NVIDIA Studio Driver)ももちろん用意されており、そちらを導入して利用できるようになる。なお、今後はゲーミング向けのドライバも提供される可能性があり、ゲームに活用したい場合には、将来的に配布が開始された段階でそちらをインストールして利用できる。
当初はPrismに依存していたWoAだが、リリースから10年近くが経過する中で、Arm ISAネイティブのアプリケーションや、x64とArm64 ISAを1つのパッケージにできるArm64ECなどに対応したソフトウェアが増えており、すでに最新バージョンのアプリケーションであれば、互換性の問題はほぼ気にしないでよくなっている。
実際「Microsoft 365 Apps」はArm64ECに対応したバージョンが提供されており、Adobe Creative Cloudも「Creative Cloud Desktop」、「Photoshop」、「Lightroom CC」、「Premiere」に関してはネイティブ版がリリースされ、Lightroom Classic、Acrobatに関してはx64版をPrism経由で利用できるようになっている。主要アプリの中では「Illustrator」と「InDesign」が未だ正式版が提供されていないが、ベータ版(かつx64版)での提供は始まっており、ベータ版であることを気にしなければ、すでに主要なCreative CloudアプリがWoAで利用できている。
また、サードパーティのIMEへの対応も課題だったが、ジャストシステムのATOKは、今年(2026年)2月にリリースされた最新版(Tech.Ver36)で、Arm版Windowsに対応した。
また、以前はインストールすらできなかったGoogle IME(Google 日本語入力)は現在公開されている最新版でWoAに対応し、インストールして動作するようになっている。Googleからの公式のアナウンスなどは見当たらないし、公式の動作環境には「64bit x86 CPU」と記載されているのだが、RTX Sparkでも動作している(もちろん動くというのとサポートなどが受けられるというのは別の議論だ、念のため)。
このように、以前はWoAでは動かなかったソフトウェアも対応が進んでおり、最新版のソフトウェアを利用するかぎりは現状ではほぼ問題なくx86 ISAのWindowsと同じように使えるようになっている。問題の性質上、100%解決したということはないが、ほぼ問題ないレベルまできているといっていいだろう。
ソフトウェア関連の話題の最後に、AAAのゲームタイトルにおける互換性について触れておきたい。WoAがリリースされた当初のAAAタイトルの互換性はお世辞にも高いとはいえなかった。その最大の理由は、その時期のPC用SnapdragonのGPU性能が低かったことで、起動はしてもゲームをプレイするに耐えなかったという状況だった。
しかし、CPUに加えてGPUの性能も強化されたSnapdragon X/X2シリーズなどがQualcommからリリースされるようになって状況が変わり、ゲームパブリッシャーもWoAへの対応を進めていき、Qualcommの表現を借りれば、「AAAタイトルの90%がプレイできる」ような状況まできている。
AAAゲームタイトルをWoA上でプレイする場合には、2つのことに注意する必要がある。1つはx64版のアプリしか提供されていない場合には、Prismで利用できるか、もう1つはAAAタイトルを利用する上で必要なアンチチートツールのArm版が提供されているかだ。
ゲームパブリッシャーがそもそもArmネイティブ版を提供している場合には何も心配しなくて良い。そのままで、何のパフォーマンスペナルティもなく、互換性の心配もなくゲームをプレイできる。それに対して、ゲームパブリッシャーがx64版のバイナリのみを提供している場合には、プレイするためにいくつかの点をチェックする必要がある。
1つ目はゲームがAVXやAVX2などのIntelの拡張命令への対応を必須としている場合だ。最初のバージョンのPrismはAVXやAVX2などに対応していなかったため、このAVX/AVX2未対応がネックになってゲームが起動しない事例があった。しかし、2024年に投入された第2世代のPrism(Prism2)の最新版ではAVX2命令の変換にも対応しており、最新のWindowsを利用している場合には問題がなくなっている。
なお、Prism/Prism2では、Direct3DなどのDirectXのAPIは、ネイティブに実行される。x64版がPrismで変換されながら実行されようが、Arm版でネイティブに実行されようが、GPU性能に関しては基本一緒だ(もちろん、CPUの処理を待つような場合には不利になる場合はある)。
多くの問題はPrism2で解決しているので、WoAでAAAゲームが起動しない要因の多くはアンチチートツールだ。アンチチートツールは、デバイスドライバの形で、Windows OSに組み込まれる。すでに説明したように、Prismはカーネルモードのソフトウェアに対しては利かないため、ゲームは「アンチチートツールがない」と判断して起動させてくれない、これが問題の根源だった。これを解決するには、ゲームパブリッシャーがアンチチートのArmネイティブ版を出してくれないかぎりはどうしようもなかったのだ。
この1、2年でその問題の解消も進んでおり、EA(Electronic Arts)を除く主要なパブリッシャーは対応するような状況になっていた。今回NVIDIAは、その最後の関門になっていたEAのアンチチートツール「EA Javelin Anticheat」がArmネイティブ版に対応する予定であることを明らかにしている。これにより、これまでWoAでは動作しなかった「F1 25」などのEAのゲームもWoAで動くようになる可能性が高く、互換性問題もほぼ解決する。
なお、AAAタイトルのゲームが動くかは互換性検証情報サイトで確認できるので、購入前に自分の持っているタイトルが動くかを確認しておくといいだろう。
なお、Blackwellの各種機能(DLSS 5、Remix、RTコアを利用したリアルタイムレイトレーシング)などは、RTX Sparkでもすべて利用できる。もちろんDLSSなどに関してはゲーム側が対応している必要があるが、それはx64のゲームでも同様であるので、Arm ISAであるから何か違いがあるかといえばそうではない。
それでは、RTX Spark N1Xの性能に関してベンチマークプログラムでチェックしていこう。ベンチマークテストを行なったのは、NVIDIAより提供された「Microsoft Surface Laptop Ultra」の128GB版(Model 2215)となる。基本的には北米向けの製品となり、キーボードは英語配列になっているが、それ以外は日本向け版と同じハードウェアになる。なお、Surfaceシリーズは、グローバルに販売される製品となっているため、規制ラベルなどは米国向けのラベルだけでなく、欧州、日本のJATEなどのラベルが電子的に添付されており、日本国内でも利用することができる。
今回その比較対象としたのは、「Microsoft Surface Laptop, 13.8インチ(第8世代)」(以下Surface Laptop 13.8インチ)になる。Surface Laptop 13.8インチは、SoCにQualcommの「Snapdragon X2 Elite(@ 4.03GHz Elite)」が採用されており、同じArm CPUであり、同じSurface Laptopということで、参考にすることにした。
なお、ベンチマークの数字自体は、下記のレビュー記事を制作したときにとっておいたデータになる。このため、ベンチマークのバージョンなどは微妙に違う場合があるので、その点はご了承いただきたい。
ベンチマークはMaxon Cinebench 2026、UL Benchmarks ProcyonのOffice Productivity Battery BenchmarkとAI Computer Vision 2.0、3DMarkの4つとなる。テスト環境は以下の表2の通りになる。
Maxon Cinebench 2026はCPUに負荷をかけて、その処理時間を計る形のシンプルなベンチマークで、シングルスレッド処理時、マルチスレッド処理時のCPU性能を計測できるテストになる。
Cinebench 2026でのSnapdragon X2 Eliteとの比較は、RTX Spark N1Xの特徴をよく示しているといえる。シングルスレッドに関してはOryon CPUになってシングルスレッドの性能がx86プロセッサと同等かそれを上回るレベルに達しているSnapdragon X2 Eliteと比較してやや劣るが、ほぼ同等の結果になっている。これはCortex-X925を採用したメリットといえるだろう。
それに対してマルチスレッドの結果は圧倒的な差があるといっていい。Snapdragon X2 Elite(@ 4.03GHz Elite)と比較して、82%ほど高い性能を発揮している。Cortex-X925が10コア、Cortex-A725が10コアであるというコア数が多い構成になっていることの恩恵だ。
もっともこれは、Surface Laptop 13.8インチに採用されているSnapdragon X2 Elite(@ 4.03GHz Elite)が、12コアと最上位のSKUではない(Snapdragon X2シリーズの最上位SKUでは18コアCPUになっている)ためでもあり、熱設計もSurface Laptop Ultraの方がより強力であることは述べておかないとフェアではないだろう。あくまでSurfaceシリーズ内での比較であるためこういう比較になっていることはお断わりしておく。
Procyon Office Productivity Battery Benchmarkは、バッテリ駆動環境でMicrosoft 365 Apps(Word、Excel、PowerPoint、Outlook)をスクリプトで自動動作させて、バッテリ駆動時間を計測するテストになる。シンプルに時間が長い方がより長時間駆動ができることになる。結果を見れば明らかなように、Snapdragon X2 Elite(@ 4.03GHz Elite)を搭載したSurface Laptop 13.8インチの方は13時間18分のバッテリ駆動が可能だったが、RTX Spark N1Xを搭載したSurface Laptop Ultraの方は10時間22分となり、単純なバッテリ駆動時間であれば、Surface Laptop 13.8インチの方が長いという結果になった。
こうなった要素の1つとして、ディスプレイの違いが挙げられる。Surface Laptop Ultraは解像度が3,270×2,180ドット/120Hzであるのに対して、Surface Laptop 13.8インチの方は2,304×1,536ドット/120Hzになっている。解像度が高いパネルの方が消費電力は多いので、SoCだけの影響ではなく、ディスプレイの影響が大きい可能性が高い。残念ながらディスプレイを外してのテストはできないので、その点はある程度割り引いて考える必要がある(なお、テスト時の輝度は同じ簡易輝度計で200cd/平方mあたりに揃えてある)。
ただ、Surface Laptop 13.8インチの方はバッテリ容量が54Wh(公称値最大)で、Surface Laptop Ultraの方は92Wh(公称値最大)となるため、バッテリの容量が1.7倍であるのにこの結果となる。バッテリ駆動時間に影響するのは、主にアイドル時の消費電力であるので、RTX Spark N1XのSnapdragon X2 Eliteに対する唯一の弱点は、アイドル時の消費電力、それに起因するバッテリ駆動時間の短さといえるだろう。
Procyon AI Computer Vision 2.0は、画像認識の処理をさせて、その処理時間を計測してスコアをたたき出す形のAI処理ベンチマークとなる。Snapdragon X2 Elite(@ 4.03GHz Elite)の方はNPUでFP8の精度でテストを行ない、RTX Spark N1Xの方はGPUでFP16の精度でテストを行なった。Snapdragonの方はFP8の精度で、RTX Sparkの方はFP16の精度で演算しているのは、シンプルにそれしか選べなかったためだ。つまり、RTX Sparkの方が倍近く不利な状況でのテストになる。
それなのに、結果はRTX Sparkの方が82%も高い性能を残している。つまり、仮に同じFP8で比較できれば、もっと性能差は開くということだ。
グラフィックスのテストに関しては説明の必要がないぐらい、RTX Sparkが圧倒的なスコアをたたき出している。Night Raid(DirectX 12向けベンチ)で1.93倍、Solar Bay(レイトレーシング)で3.42倍、Steel Nomad Light(軽量PC向けグラフィックスベンチ)で3.78倍という圧倒的な結果になっている。
こうした結果から、RTX Sparkを搭載したSurface Laptop Ultraと、Snapdragon X2 Eliteを搭載したSurface Laptop 13.8インチを比較するのであれば、処理能力という性能を重視するなら明らかにRTX Sparkを採用したSurface Laptop Ultra、それに対してバッテリ駆動時間や軽量さ(Surface Laptop Ultraは2kg、Surface Laptop 13.8インチは1.36kg)のバランスをとるならSurface Laptop 13.8インチだといえる。
ではRTX Sparkの売りは何なのかといえば、やはり、「買ってすぐにエージェント型AIが実行できる」という点にあるのではないだろうか。難しいことを考えなくても、はじめにの画面からエージェント型AIを選んでいくだけで導入が開始され、難しい設定などをしなくてもすぐに利用できるというのは、一般消費者向けのOSでもあるWindowsの真骨頂だといえる。「ローカルエージェント型AIの大衆化(誰にでも簡単に使えるということ)」という一種の理想郷がそこにある。
もちろん、ハッキリ言って安くはない。同じ24GB/512GBのモデルで比較しても、Surface Laptop 13.8インチは38万2,580円(税込)であるのに対して、Surface Laptop Ultraの方は51万3,480円(税込)だ。Surface Laptop Ultraの方が15型のディスプレイなのだが、フェアな比較ではないというのなら、15型のSurface Laptopの24GB/512GBモデルは41万8,880円(税込)だ。
しかし、これを活用して何をするかで、考え方は変わってくるだろう。約10万円の追加コストで、高性能を手に入れ、同時にエージェント型AIを毎日持ち歩くノートPCで走らせる……それによりできる仕事量が増えることになる。筆者のように自由業のクリエイター職などであれば、より多くの仕事を請けて、報酬を増やすことができる。企業で働いているビジネスパーソンであれば、自分の成果を増やして評価を上げたり、空いた時間を余暇に使うこともできるようになるだろう。そうした職種の人であれば、すぐに元が取れるのではないだろうか。
これまでWindowsノートPC向けのSoCは、10年前まではIntelがほとんどすべての選択肢だったが、5年前ぐらいからAMDが現実的な選択肢になり、2年前からそこにQualcommが加わった。そして、今その列にNVIDIAが加わろうとしている。ユーザーにとっては選択肢が増えたことを意味し、自分のニーズにあったSoCを選べるようになったということだ。そのことは素直に歓迎していいと思うし、今後AMDやIntel、そしてQualcommがどういう逆襲に出てくるのかも楽しみだ。